유튜브 API 하루 1만 유닛으로 버티기
요약
- 새 영상은 유튜브 채널 RSS로 받습니다. 할당량이 들지 않아요. 유튜브 API는 RSS가 알려 주지 않는 것(영상 길이, 라이브 상태, 채널 사진, 댓글)을 채우고, RSS를 받지 못했을 때 대신 받는 데 씁니다.
- API로 받은 것은 채널마다 서버에 캐시해서 모든 사용자가 같이 씁니다. 그래서 피드를 새로 받는 비용은 사용자 수가 아니라 서로 다른 채널 수와 새 영상 수를 따라갑니다.
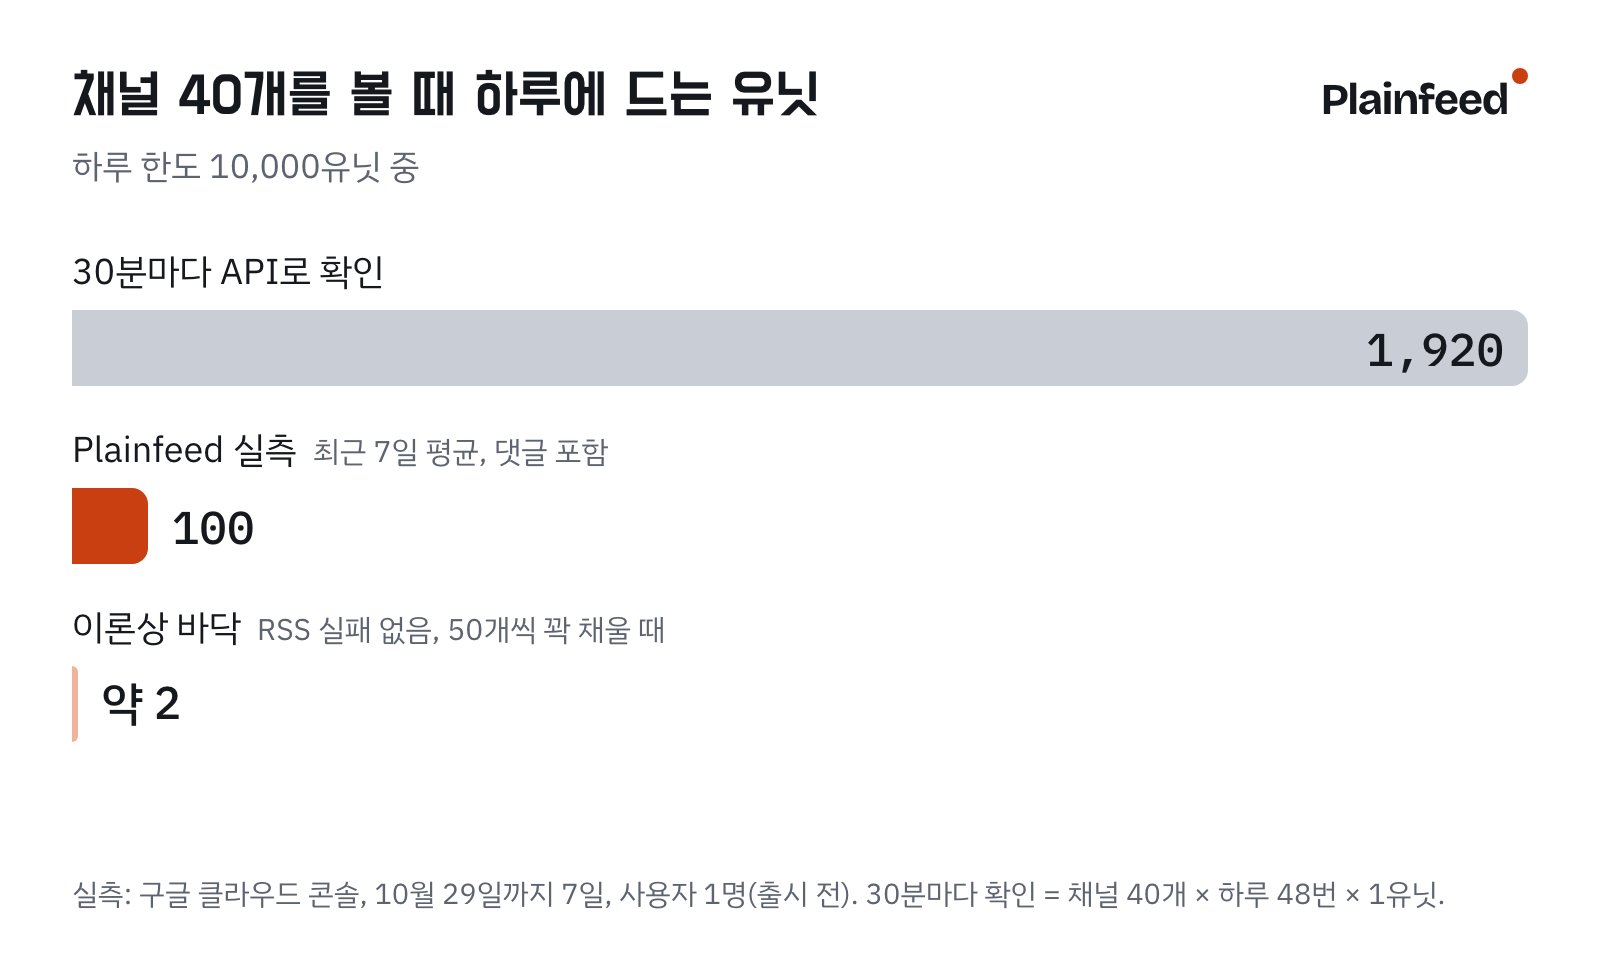
- 지난 7일 동안 실제로 쓴 양은 701유닛, 하루 약 100유닛(한도의 1%)이었습니다. 아직 출시 전이라 사용자는 저 하나, 채널은 40개입니다. 그리고 가장 많이 쓴 곳은 예상 밖이었어요.
Plainfeed는 고른 유튜브 채널의 새 영상만, 추천과 쇼츠 없이 올라온 순서대로 보여주는 웹사이트예요. 서버는 Cloudflare 무료 플랜 하나로 돌립니다.
이런 걸 만들면 제일 먼저 부딪히는 벽이 유튜브 Data API 할당량입니다. 프로젝트 하나에 하루 1만 유닛이고, 돈을 내고 늘리는 방법은 없어요. 늘리려면 감사를 거쳐야 합니다. 이 글은 그 1만 유닛 안에서 구독 피드를 굴리려고 내린 결정들과, 그 결정이 실제로 얼마나 버티는지를 숫자로 정리한 기록입니다.
용어 세 가지만 먼저요.
- 유닛: 유튜브 API를 부를 때마다 깎이는 점수예요. 프로젝트마다 하루 1만 점이고, 태평양 시각 자정에 다시 채워져요.
- RSS: 채널마다 공개된 새 영상 목록 파일이에요. 받아도 유닛이 들지 않아요.
- WebSub: 새 영상이 올라오면 구글이 서버로 알려 주는 방식이에요.
할당량은 이렇게 생겼습니다
먼저 지켜야 할 조건부터 정리했습니다. 2026년 10월에 공식 문서를 다시 읽고 확인한 내용이에요.
| 항목 | 내용 |
|---|---|
| 기본 할당량 | 프로젝트마다 하루 10,000유닛 (대부분의 메서드가 같이 씀) |
| search.list, videos.insert | 2026년 6월부터 따로: 각각 하루 100번까지, 한 번에 1유닛 |
| videos.batchGetStats | 2026년 6월에 새로 생김. 따로 하루 10,000유닛, 한 번에 1유닛 |
| 목록 읽기 (videos.list 등) | 대부분 한 번에 1유닛, 다음 쪽을 받으면 또 1유닛 |
| 쓰기 (구독 추가 등) | 대부분 한 번에 50유닛 |
| 잘못된 요청 | 실패해도 최소 1유닛 |
| 초기화 | 태평양 시각 자정 (한국 시각 16시 또는 17시) |
| 늘리기 | 신청서를 내고 감사를 받아야 함. 유료로 늘리는 방법은 없음 |
정책도 두 가지 붙습니다. API로 받은 데이터는 30일 안에 새로 받거나 지워야 하고(개발자 정책 III.E.4), API 클라이언트 하나에는 API 프로젝트를 정확히 하나만 만들어야 합니다(III.D.1.c). 프로젝트를 여러 개 만들어 할당량을 나눠 쓰는 길은 처음부터 없는 셈이에요.
Plainfeed 쪽 조건은 이렇습니다. 채널은 몇 개든 넣을 수 있고(앱은 서버에 30개씩 나눠 묻습니다), 새 영상은 보통 올라오고 30분 안에는 보여야 합니다.
그냥 API로 만들면 몇 유닛일까
먼저 떠오르는 방법들로 계산해 보면 이렇습니다.
| 방법 | 드는 양 | 한계 |
|---|---|---|
| 채널마다 search.list로 최신 영상 찾기 | 채널 하나 확인에 1번 | 하루 100번이 프로젝트 전체 한도라, 채널 30개를 넣은 사용자가 3명이면 하루에 한 번씩밖에 못 봄 |
| 채널마다 업로드 목록(playlistItems.list)을 30분마다 | 채널 하나에 하루 48유닛 | 1만 유닛으로 종일 볼 수 있는 채널이 약 208개 |
| 채널 RSS + 새 영상만 videos.list (Plainfeed) | 새 영상 50개에 1유닛 | 아래에서 |
사실 Plainfeed의 첫날 버전은 첫 번째 방법을 썼습니다. 그때는 유튜브 카테고리별로 최신 영상을 모아 보여주는 사이트였고, 카테고리마다 3~8시간 간격으로 search.list를 불렀어요. 그때 적어 둔 설계 문서에는 "1회 100유닛"이라고 되어 있습니다. 하루 몇 번만 돌아도 할당량의 큰 덩어리가 나가는 구조라 그날 바로 채널 RSS로 바꿨고, 콘솔의 지난 30일 기록에 남은 search.list 31번이 그 흔적이에요.
그런데 이 글을 쓰려고 공식 문서를 다시 읽어 보니, 그 메모는 쓴 날부터 틀린 내용이었습니다. Plainfeed 첫 커밋보다 넉 달도 더 전인 2026년 6월부터, search.list는 1만 유닛과 따로 하루 100번짜리 별도 한도를 씁니다. 100유닛짜리든 하루 100번짜리든, 구독 피드를 search로 만들 수 없다는 결론은 같아요.
결정 1: 새 영상은 RSS로 (0유닛)
결론: 새 영상 목록은 무료 RSS로 받습니다. 할당량이 들지 않아요.
유튜브에는 채널마다 공개 RSS 피드가 있습니다.
https://www.youtube.com/feeds/videos.xml?channel_id=UC...
API 키도 할당량도 필요 없어요. 공식 문서에 설명된 피드는 아니라서, 아래는 2026년 10월에 직접 받아 보고 확인한 내용입니다. 최신 영상 15개의 제목, 올린 시각, 조회수, 링크가 들어 있어요. 링크에 /shorts/가 들어 있으면 쇼츠라서, 길이를 몰라도 걸러낼 수 있습니다. 지금 서버에 받아 둔 영상 590개 중 153개(26%)가 이렇게 공짜로 걸렸어요.
대신 RSS로는 알 수 없는 것이 있습니다.
- 영상 길이:
/shorts/링크가 아닌 짧은 영상도 있어서, 쇼츠를 다 거르려면 길이가 필요합니다. - 라이브 상태: 지금 방송 중인지, 예정인지, 끝난 방송인지, 언제 시작하는지.
- 15개보다 오래된 영상: 하루에 영상을 많이 올리는 채널은 앞의 것이 밀려납니다.
그리고 브라우저는 유튜브 RSS를 직접 읽을 수 없어서(CORS), 같은 사이트의 서버 함수(Cloudflare Pages Functions)가 대신 받습니다. API 키도 브라우저에 둘 수 없으니 어차피 서버가 필요했어요.
결정 2: API는 RSS가 모르는 것에
결론: 영상 길이, 라이브 상태, 채널 사진, 댓글처럼 RSS에 없는 것만 API로 묻고, 50개씩 묶어 한 번에 1유닛으로 끝냅니다.
| 쓰는 곳 | 메서드 | 드는 양 | 얼마나 자주 |
|---|---|---|---|
| 영상 길이·라이브 상태 | videos.list | 50개까지 한 번에 1유닛 | 새 영상이 생겼을 때. 받은 정보는 7일, 방송 중이면 5분 |
| 채널 사진 | channels.list | 50개까지 1유닛 | 채널마다 7일에 한 번 |
| 댓글·답글 | commentThreads.list, comments.list | 쪽마다 1유닛 | 댓글 탭을 열었을 때만. 30분 캐시 |
| 주소로 채널 추가 | channels.list (영상 주소면 videos.list도) | 1~2유닛 | 추가할 때. 같은 주소는 하루 캐시 |
videos.list는 영상 ID를 한 번에 50개까지 받아 주어서(설명 문서에 숫자는 없지만 실제 한도), 새 영상 50개를 1유닛에 확인합니다. 길이가 3분(180초) 이하면 쇼츠로 보고 뺍니다(라이브 다시보기는 짧아도 남겨요). RSS 링크로 못 거른 짧은 영상이 이렇게 73개 더 걸렸습니다.
// 받아 둔 정보가 오래된 영상만, 50개씩 묻는다 (한 번에 1유닛). 줄인 코드
for (let i = 0; i < ids.length; i += 50) {
  const body = await api("videos", {
    part: "contentDetails,liveStreamingDetails,snippet,statistics",
    id: ids.slice(i, i + 50).join(","),
  });
  for (const v of body.items) {
    out[v.id] = {
      duration: parseDuration(v.contentDetails.duration),   // 180초 이하면 쇼츠
      state: v.snippet.liveBroadcastContent,                 // live, upcoming, none
      start: v.liveStreamingDetails?.actualStartTime,       // 라이브는 시작 시각 자리에
    };
  }
}
일부러 하지 않은 것도 있습니다. 이 사이트에서 바로 구독하는 버튼은 만들지 않았어요. 구독 추가(subscriptions.insert)는 한 번에 50유닛이고 계정 쓰기 권한까지 받아야 해서, 구독은 유튜브에서 하도록 넘깁니다.
결정 3: 채널마다 캐시하고, 모두가 같이 쓴다
결론: 받은 결과는 채널 단위로 저장해서 모든 사용자가 같이 씁니다. 사용자가 늘어도 비용은 거의 늘지 않아요.
받은 결과는 Cloudflare D1(SQLite)에 채널마다 한 줄로 둡니다. 그 한 줄 안에 RSS 결과와 영상별 길이·라이브 상태, 채널 사진이 받은 시각과 함께 들어 있어요.
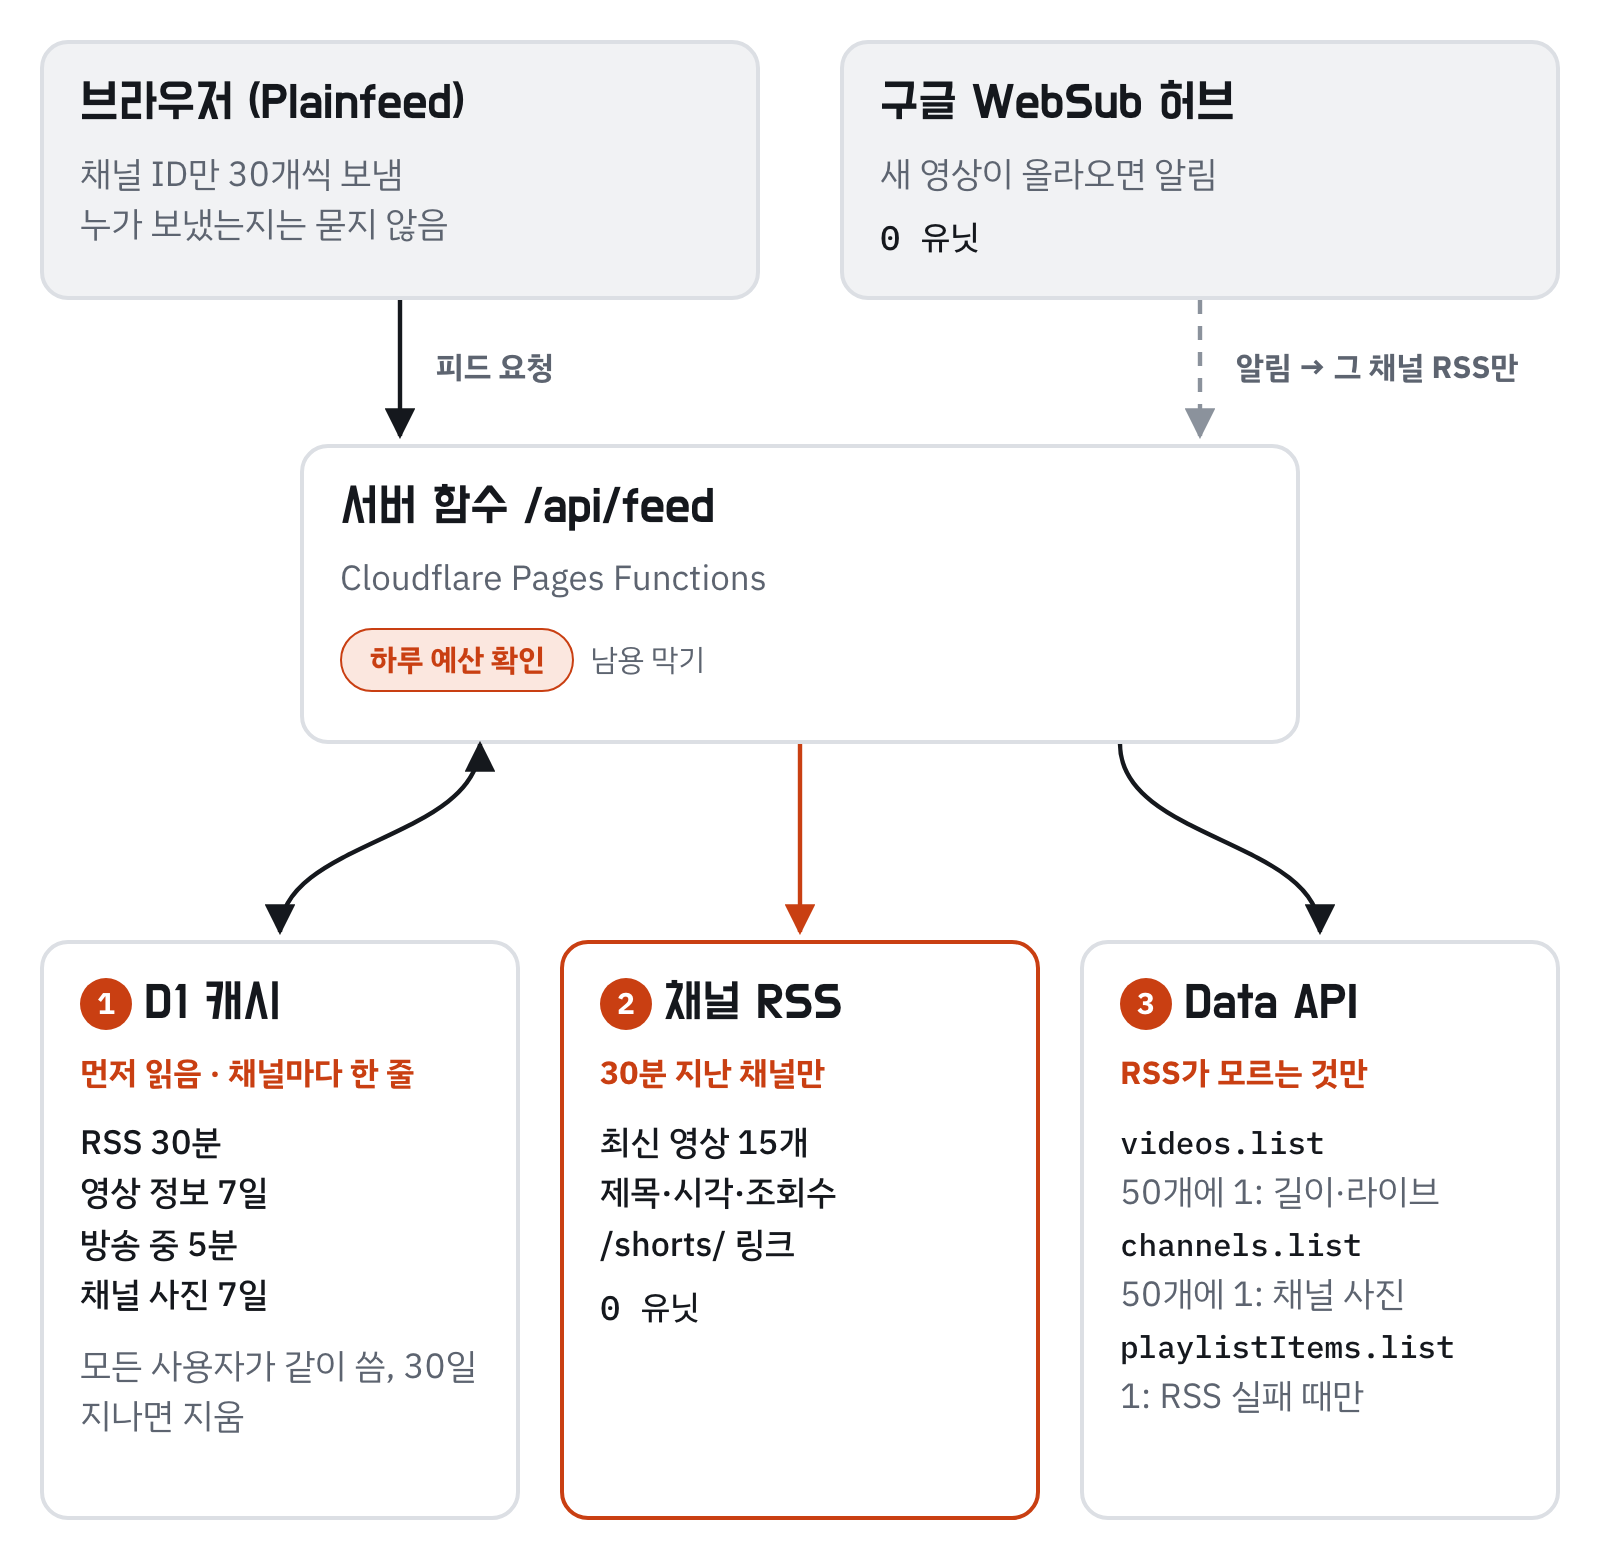
핵심은 이 캐시를 사용자끼리 나눠 쓴다는 점입니다. 피드 요청에는 채널 ID만 들어 있고, 캐시는 채널 단위라 누가 요청했는지와 상관없이 같은 결과를 줍니다. 같은 채널을 구독한 사람이 1명이든 1,000명이든, 그 채널의 영상 정보는 한 번만 받아요. 그래서 할당량은 사용자 수가 아니라 서로 다른 채널 수와, 그 채널들이 올리는 새 영상 수를 따라갑니다.
API로 받은 정보는 30일 정책 때문에 오래 들고 있을 수 없습니다. 매일 한 번 도는 정리 작업이 30일 넘게 새로 받지 못한 줄을 지우고, 다음 요청 때 다시 받습니다.
결정 4: 새 영상 알림(WebSub)으로 기다리지 않기
결론: 30분마다 확인하는 대신, 새 영상이 올라오면 구글이 알려 주게 했습니다. 이것도 0유닛이에요.
RSS를 30분마다 다시 받는 방식이면, 아무도 사이트를 열지 않는 동안 서버는 새 영상을 모릅니다. 그래서 유튜브의 공식 새 영상 알림인 WebSub(PubSubHubbub)를 붙였어요. 구글 허브에 채널을 구독해 두면 새 영상이 올라오거나 영상 제목·설명이 바뀔 때 서버로 알림이 오고, 서버는 그 채널의 RSS만 바로 다시 받습니다. 이것도 할당량이 들지 않아요.
알림은 누구나 보낼 수 있는 주소로 오기 때문에 내용은 믿지 않습니다. 채널마다 다른 비밀값으로 서명을 확인하고, 맞으면 RSS를 다시 받을 뿐이에요. 알림이 늦거나 빠질 때를 위해 30분 캐시는 그대로 둡니다.
결정 5: 남이 쓸 수 있는 양에 하루 예산
결론: 로그인 없이 부를 수 있는 기능마다 하루 사용량 상한을 걸었습니다.
여기까지는 정상적으로 쓸 때 이야기입니다. 그런데 Plainfeed는 로그인 없이 쓸 수 있어서, 피드·채널 추가·댓글 API를 아무나 부를 수 있어요. 직접 점검해 보니 채널 주소나 댓글 다음 쪽 토큰을 바꿔 가며 부르면 몇 시간 만에 할당량이 바닥나는 길이 있었습니다.
그래서 비싼 일마다 하루 예산을 걸었습니다.
| 일 | 하루 전체 | 요청한 곳마다 | 넘으면 |
|---|---|---|---|
| 처음 보는 채널 받기 | 1,000개 | 150개 | 받지 못한 채널로 두고 다음에 다시 |
| 30분 지난 채널 다시 받기 | 20,000개 | 2,000개 | 받아 둔 것을 그대로 |
| 주소로 채널 찾기 | 1,500번 | 100번 | 받아 둔 게 없으면 "오늘 처리할 수 있는 양을 넘었어요" |
| 댓글·답글 | 3,000번 | 400번 | 〃 |
"요청한 곳"은 IP를 그대로 저장하지 않고, 날마다 바뀌는 비밀 해시로만 구분해요.
다 더해 보면 댓글과 채널 찾기만으로도 운이 나쁜 날에는 하루 4,500~6,000유닛까지 나갈 수 있습니다. 1만 안에는 들지만 여유가 큰 건 아니라서, 사용자가 늘면 이 숫자부터 다시 볼 생각이에요.
할당량 말고도 잘라야 할 게 두 가지 있었습니다.
- RSS가 실패하면 업로드 목록(playlistItems.list, 1유닛)으로 대신 받는데, 전에 받아 둔 적 있는 채널만, 요청 한 번에 6개까지만 합니다. 없는 채널 ID를 잔뜩 보내서 할당량을 쓰게 만들 수 없게요. 잘못된 요청도 1유닛은 나가니까요.
- Cloudflare 무료 플랜은 요청 하나에 외부 호출이 50번까지라, 앱이 채널을 30개씩 나눠서 묻습니다.
try {
  feed = await fetchRss(id);                 // 0유닛
} catch (e) {
  // 대신 받기는 전에 받아 둔 채널만, 요청당 6개까지,
  // 대신 받기마저 실패했던 채널은 1시간 쉰다. 줄인 코드
  if (!known || fallbacks >= 6 || now - failedAt < 3600) throw e;
  fallbacks++;
  feed = await fetchUploads(id);             // playlistItems.list: 1유닛
}
예상과 달랐던 것
1. 할당량을 가장 많이 쓴 건 "대신 받기"였습니다. 지난 7일 동안 쓴 701유닛 중 309유닛(44%)이 RSS가 실패해서 업로드 목록으로 대신 받은 몫이에요. RSS는 공짜라 실패도 드물 거라고 생각했는데 아니었습니다. 이상한 건, 이 글을 쓰면서 같은 채널 40개의 RSS를 제 컴퓨터에서 받아 보면 40개 모두 바로 받아진다는 점이에요. 클라우드 서버에서 부를 때만 가끔 막히는 것 같은데, 아직 확인하지 못한 추정입니다.
2. 없어진 채널이 요청마다 1유닛씩 썼습니다. RSS 실패, 대신 받기도 실패, 다음 요청에서 또 시도. 채널이 지워지거나 비공개로 바뀌면 이걸 끝없이 되풀이합니다. 대신 받기까지 실패하면 그 시각을 적어 두고 1시간 동안은 다시 시도하지 않게 고쳤어요(위 코드의 failedAt).
3. "50개에 1유닛"은 가장 좋을 때 이야기였습니다. 40개 채널의 새 영상은 하루 25개쯤이고, 7일마다 다시 확인하는 영상(쇼츠 링크가 아닌 약 440개)까지 더해도 50개씩 꽉 채우면 하루 2번이면 됩니다. 그런데 7일 동안 videos.list는 270번(하루 약 39번) 불렸어요. 새 영상은 보통 한두 개씩 생기고, 방송 중인 라이브(5분)와 예정 방송을 다시 확인하는 일까지 섞이면서, 실제로는 대부분의 호출에 ID가 몇 개 안 들어갑니다. 호출마다 이유를 따로 세지는 않아서 이것도 추정이에요.
4. 제 설계 문서가 첫날부터 틀려 있었습니다. 앞에서 쓴 search.list 이야기예요. 규칙은 제가 적기 몇 달 전에 이미 바뀌어 있었습니다. 숫자가 들어간 글은 발행 직전에 문서를 다시 읽어야 한다는 걸 배웠어요.
실제로 쓴 양
구글 클라우드 콘솔의 YouTube Data API 측정항목에서 2026년 10월 29일까지 7일 동안의 메서드별 요청 수를 옮겼습니다. 여기 나오는 메서드는 모두 한 번에 1유닛이라, 요청 수가 곧 유닛이에요.
| 메서드 | 7일 동안 (유닛) | 쓰는 곳 |
|---|---|---|
| playlistItems.list | 309 | RSS 대신 받기 |
| videos.list | 270 | 영상 길이·라이브 상태 |
| commentThreads.list | 58 | 댓글 |
| channels.list | 32 | 채널 사진, 주소로 채널 추가 |
| subscriptions.list | 21 | 구글 계정으로 구독 가져오기 |
| comments.list | 11 | 답글 |
| 합계 | 701 | 하루 약 100유닛 (한도의 1%) |
구독 가져오기는 사용자의 구글 토큰으로 브라우저에서 부르는데도, 할당량은 Plainfeed 프로젝트에서 나간다는 점도 이번에 확인했습니다.
숫자를 읽을 때 조건이 있어요. 아직 출시 전이라 실제 사용자는 저 하나고, 채널은 40개이며, 제가 개발하면서 직접 부른 몫도 섞여 있습니다. 사람이 늘면 숫자도 늘어요. 다만 늘어나는 방향은 정해져 있습니다. 같은 채널을 보는 사람이 늘어나는 건 거의 공짜고, 새로운 채널과 그 채널들의 새 영상이 늘어날 때 비용이 붙어요.
같은 채널 40개를 기준으로 비교하면 이렇습니다.
하지 않은 것, 다음에 할 것
- 할당량 늘리기 신청은 아직 하지 않았습니다. 감사를 거쳐야 해서, 실제로 한도에 가까워지면 신청하려고 해요.
- 프로젝트를 나누지 않습니다. 앞에서 쓴 대로 정책상 API 클라이언트 하나에 프로젝트 하나입니다.
- 대신 받기에도 하루 상한을 따로 둘 생각입니다. 지금은 요청당 6개와 "다시 받기" 예산으로만 묶여 있어서, RSS가 크게 막히는 날에는 대신 받기가 할당량을 많이 쓸 수 있어요. 이 글을 쓰면서 찾은 구멍입니다.
- 영상 길이를 videos.batchGetStats로 옮기기. 2026년 6월에 새로 생긴 메서드로, 1만 유닛과 따로 하루 1만 유닛짜리 몫을 쓰고 영상 길이를 줍니다. 라이브 상태는 주지 않아서 방송은 계속 videos.list로 봐야 해요. 이 글의 사실 확인을 하다가 알았습니다.
- 오래된 영상 찾기는 업로드 목록을 50개씩(1유닛) 받아 30일 캐시하는 방식으로, 필요해지면 붙일 계획이에요. search.list는 앞으로도 쓰지 않습니다.
마치며
할당량을 아끼는 비결은 API를 덜 부르는 요령보다 API에 물어볼 필요가 없는 구조에 있었습니다. 새 영상은 RSS와 알림으로 알고, API는 RSS가 알려 주지 않는 것을 채우고, 그 결과는 모두가 같이 씁니다. 계획대로 되지 않은 곳(RSS 대신 받기)이 다음에 손볼 곳이에요.
다음 글에서는 같은 서버를 Cloudflare 무료 플랜 하나로 운영하면서, D1의 하루 읽기·쓰기 한도를 남이 다 쓰지 못하게 막은 이야기를 써 보겠습니다.